Human in the Loop: Menjaga Kualitas Otomatisasi AI
Anda ingin AI membaca faktur, mengklasifikasi email, atau menyusun draf balasan pelanggan. Tapi Anda juga tidak mau AI salah membayar vendor Rp50 juta atau mengirim jawaban ngawur ke pelanggan penting. Human in the loop adalah jalan tengahnya: AI mengerjakan sebagian besar pekerjaan, manusia memeriksa bagian yang berisiko atau yang AI sendiri kurang yakin.
Artikel ini membahas cara merancang human in the loop yang praktis: di mana titik review-nya, kapan AI boleh jalan sendiri, dan bagaimana koreksi dari tim membuat sistem makin baik.
Apa itu human in the loop?
Human in the loop (sering disingkat HITL) artinya ada manusia di dalam alur kerja otomatis. Manusia tidak mengerjakan semuanya dari nol, tapi memeriksa, menyetujui, atau memperbaiki hasil sistem pada titik tertentu.
Ada tiga pola yang umum:
- Review sebelum aksi: AI menyiapkan hasil, manusia menyetujui sebelum hasil dipakai. Contoh: draf email ke pelanggan dikirim setelah agen CS klik “setuju”.
- Review sebagian: hanya kasus tertentu yang masuk ke manusia, sisanya jalan otomatis. Contoh: faktur dengan nominal kecil dan data lengkap langsung dicatat, sisanya dicek admin.
- Review sesudah aksi (sampling): semua jalan otomatis, lalu manusia memeriksa sampel secara berkala. Contoh: 5% hasil klasifikasi dokumen dicek setiap minggu.
Pola kedua biasanya paling pas untuk bisnis. Manusia tidak kebanjiran pekerjaan, tapi keputusan berisiko tetap dipegang orang.
Kenapa ini perlu? Karena model AI bisa salah dengan nada yakin. Fenomena halusinasi AI tidak bisa dihilangkan sepenuhnya, hanya bisa dikurangi dan dikendalikan. Human in the loop adalah salah satu kendalinya.
Menentukan titik review
Tidak semua langkah perlu dicek manusia. Kalau semuanya dicek, AI tidak menghemat waktu. Pertanyaan yang membantu menentukan titik review:
- Apa akibatnya kalau salah? Salah memberi label email internal akibatnya kecil. Salah mentransfer uang atau salah menolak klaim akibatnya besar.
- Apakah bisa dibatalkan? Draf yang belum terkirim gampang diperbaiki. Email yang sudah terkirim ke pelanggan tidak bisa ditarik.
- Siapa yang terkena dampak? Kesalahan yang hanya dilihat tim internal lebih aman dibanding yang langsung terlihat pelanggan, vendor, atau regulator.
- Seberapa sering kasusnya? Kasus langka dan aneh lebih rawan salah dibanding kasus yang muncul ratusan kali sehari.
Contoh di sebuah distributor yang memakai AI untuk membaca faktur pembelian:
| Langkah | Risiko | Perlakuan |
|---|---|---|
| Membaca nomor faktur, tanggal, nama vendor | Rendah, mudah dicocokkan | Otomatis |
| Mencocokkan faktur dengan purchase order | Sedang | Otomatis kalau cocok, review kalau selisih |
| Menjadwalkan pembayaran | Tinggi, menyangkut uang keluar | Selalu disetujui manusia |
Ambang keyakinan: kapan AI boleh jalan sendiri
Cara paling umum membagi kasus adalah memakai skor keyakinan (confidence score). Sistem memberi nilai seberapa yakin hasilnya benar, lalu Anda menetapkan ambang batas.
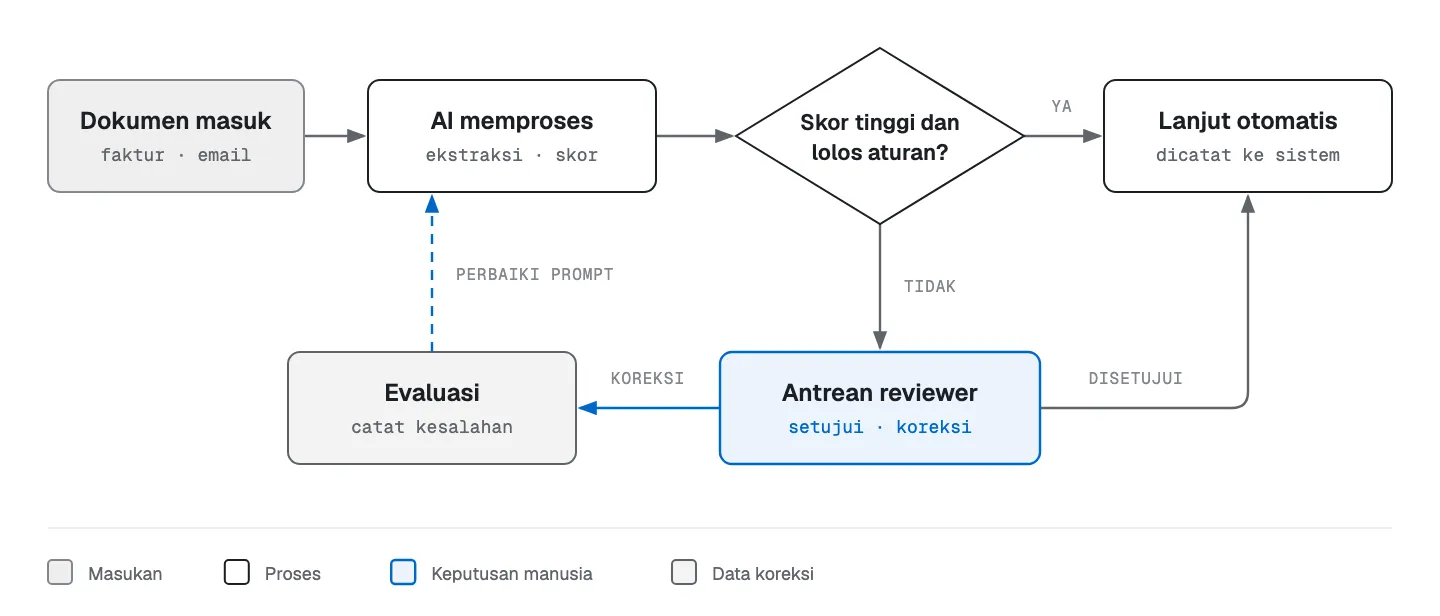
Beberapa catatan penting soal skor keyakinan:
- Skor dari model bahasa tidak selalu bisa dipercaya mentah-mentah. Model bisa bilang “yakin 95%” padahal salah. Lebih aman menggabungkan beberapa sinyal.
- Pakai aturan yang bisa dicek. Contoh: total faktur harus sama dengan jumlah item, NPWP harus 15 atau 16 digit, tanggal tidak boleh di masa depan. Kalau aturan gagal, kirim ke manusia apa pun skornya.
- Minta output terstruktur. Dengan structured output, AI mengisi field yang jelas (misalnya “vendor”, “total”, “kategori”), jadi validasinya bisa otomatis.
- Mulai dengan ambang yang ketat. Di minggu pertama, lebih baik 60% kasus masuk review daripada kesalahan lolos. Longgarkan pelan-pelan setelah data akurasinya terkumpul.
Selain skor, tambahkan aturan bisnis. Misalnya: semua transaksi di atas Rp10 juta wajib disetujui manusia, berapa pun skornya. Pelanggan kategori VIP selalu dibalas setelah dicek agen.
Desain antrean review
Bagian ini sering dilupakan. Kasus yang masuk ke manusia harus mudah dikerjakan, kalau tidak antreannya menumpuk dan orang mulai asal klik “setuju”.
Antrean review yang baik punya ciri berikut:
- Satu tempat. Semua kasus yang perlu dicek ada di satu daftar. Jangan sampai tersebar di email, chat, dan spreadsheet.
- Konteks lengkap. Reviewer melihat dokumen asli di sebelah hasil AI, jadi tidak perlu membuka file lain.
- Alasan masuk review. Tulis kenapa kasus ini dicek: “skor rendah”, “total tidak cocok”, “nominal di atas batas”. Reviewer jadi tahu harus fokus ke mana.
- Aksi yang jelas. Setujui, perbaiki lalu setujui, atau tolak. Kalau memperbaiki, reviewer mengedit field-nya langsung.
- Batas waktu dan pengingat. Kasus yang belum dicek dalam 24 jam memicu pengingat, misalnya lewat email atau WhatsApp.
- Pemilik yang jelas. Setiap jenis kasus punya penanggung jawab dan cadangannya saat cuti.
Secara teknis, antrean bisa dibangun sederhana: tabel di Google Sheets atau database, halaman internal kecil, atau fitur persetujuan di tools otomatisasi. Di n8n, misalnya, Anda bisa memakai alur approval dengan Wait node atau operasi kirim pesan lalu menunggu jawaban di beberapa node chat dan email. Untuk volume besar, halaman review khusus biasanya lebih nyaman.
Belajar dari koreksi
Setiap kali reviewer memperbaiki hasil AI, itu data berharga. Simpan tiga hal: hasil AI, hasil setelah dikoreksi, dan jenis kesalahannya.
Dari data ini Anda bisa:
- Mengukur akurasi sebenarnya per jenis dokumen atau kategori.
- Menemukan pola kesalahan. Misalnya AI sering salah membaca faktur dari satu vendor dengan format tabel yang aneh.
- Memperbaiki prompt atau aturan. Tambahkan contoh kasus yang sering salah ke prompt, atau tambahkan aturan validasi baru.
- Menyesuaikan ambang. Kategori yang akurasinya sudah stabil tinggi bisa dilonggarkan. Kategori yang sering salah tetap diperketat.
- Membuat set uji. Kumpulan kasus yang pernah salah dipakai untuk menguji setiap kali prompt atau model diganti.
Dengan siklus ini, porsi pekerjaan yang masuk review biasanya berkurang dari waktu ke waktu. Tapi jangan pernah menghapus review untuk keputusan berisiko tinggi, secanggih apa pun modelnya.
Contoh penerapan di bisnis
Beberapa contoh yang realistis:
- Klinik: AI menyusun ringkasan keluhan dari form pendaftaran online, perawat memeriksa sebelum ringkasan masuk ke catatan pasien.
- Agensi: AI membuat draf laporan bulanan untuk klien, account manager mengecek angka dan kalimat sebelum dikirim.
- Toko online: AI mengelompokkan ulasan pelanggan, hanya ulasan yang terdeteksi sebagai keluhan serius yang diteruskan ke supervisor.
- Tim keuangan: AI membaca dan mengklasifikasi dokumen yang masuk, admin memeriksa yang skornya rendah atau nominalnya besar.
Contoh lain bisa Anda lihat di bagian contoh penerapan di halaman utama kami.
Kalau Anda ingin memakai AI di proses kerja tapi masih ragu soal kontrolnya, Aqilatic bisa membantu menentukan titik review dan ambang yang masuk akal lewat audit proses gratis.
Pertanyaan yang sering muncul
Apakah human in the loop membuat AI jadi lambat?
Hanya untuk kasus yang masuk review. Kasus yang jelas dan berisiko rendah tetap jalan otomatis dalam hitungan detik. Yang penting antrean review-nya dirancang supaya cepat dikerjakan.
Berapa persen kasus yang sebaiknya masuk review?
Tidak ada angka baku. Di awal, wajar kalau porsinya besar. Setelah akurasi per kategori terukur dari data koreksi, ambangnya bisa disesuaikan sampai beban review seimbang dengan risikonya.
Apakah human in the loop hanya untuk AI?
Tidak. Konsep yang sama berlaku untuk otomatisasi biasa, misalnya approval pengeluaran di atas nominal tertentu. Bedanya, di sistem AI hasilnya lebih sulit ditebak, jadi titik review jadi lebih penting.