RAG Adalah: Cara AI Menjawab dari Dokumen Perusahaan
RAG adalah singkatan dari Retrieval-Augmented Generation, teknik yang membuat AI mencari dulu informasi di dokumen Anda sebelum menjawab. Jadi saat staf bertanya “berapa batas reimbursement perjalanan dinas?”, AI tidak menebak dari pengetahuan umum. AI membuka SOP perusahaan, menemukan bagian yang relevan, lalu menjawab sambil menyebut sumbernya.
Kalau Anda pernah mencoba ChatGPT atau chatbot AI lain untuk pertanyaan internal, Anda mungkin sadar masalahnya: AI terdengar yakin, tapi jawabannya tidak sesuai aturan perusahaan Anda. RAG dibuat untuk mengatasi masalah itu.
Pengertian RAG
Istilah RAG diperkenalkan dalam makalah riset tahun 2020 oleh tim peneliti Facebook AI Research (sekarang Meta AI), berjudul Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Idenya sederhana: gabungkan dua kemampuan.
- Retrieval (pengambilan): mencari potongan informasi yang relevan dari kumpulan dokumen.
- Generation (pembuatan jawaban): model bahasa menyusun jawaban dalam kalimat yang enak dibaca.
Bayangkan karyawan baru yang pintar menulis tapi belum hafal aturan kantor. Kalau Anda bertanya soal prosedur retur barang, dia akan mengarang. Tapi kalau dia boleh membuka buku SOP dulu, jawabannya jadi akurat. RAG memberi AI “izin membuka buku” sebelum menjawab.
Kenapa LLM saja tidak cukup
LLM (large language model) seperti GPT, Claude, atau Gemini dilatih dari data publik dalam jumlah sangat besar. Kemampuan bahasanya bagus, tapi ada tiga keterbatasan untuk kebutuhan bisnis:
- Tidak tahu dokumen internal Anda. Daftar harga, SOP, kontrak klien, dan kebijakan HR tidak ada di data latihnya.
- Pengetahuannya punya batas waktu. Informasi setelah model dilatih tidak ikut diketahui.
- Bisa mengarang. Saat tidak tahu, LLM cenderung tetap memberi jawaban yang terdengar meyakinkan. Ini sering disebut halusinasi.
Anda bisa saja menempelkan seluruh dokumen ke dalam chat setiap kali bertanya. Untuk satu atau dua file, cara ini masih bisa. Tapi kalau dokumennya ratusan, cara ini lambat, mahal, dan tidak praktis dipakai banyak orang. RAG menyelesaikannya dengan hanya mengambil potongan yang relevan untuk setiap pertanyaan.
Komponen RAG
Sistem RAG punya dua bagian: persiapan dokumen (dilakukan di awal dan diperbarui berkala) dan proses menjawab (terjadi setiap ada pertanyaan).
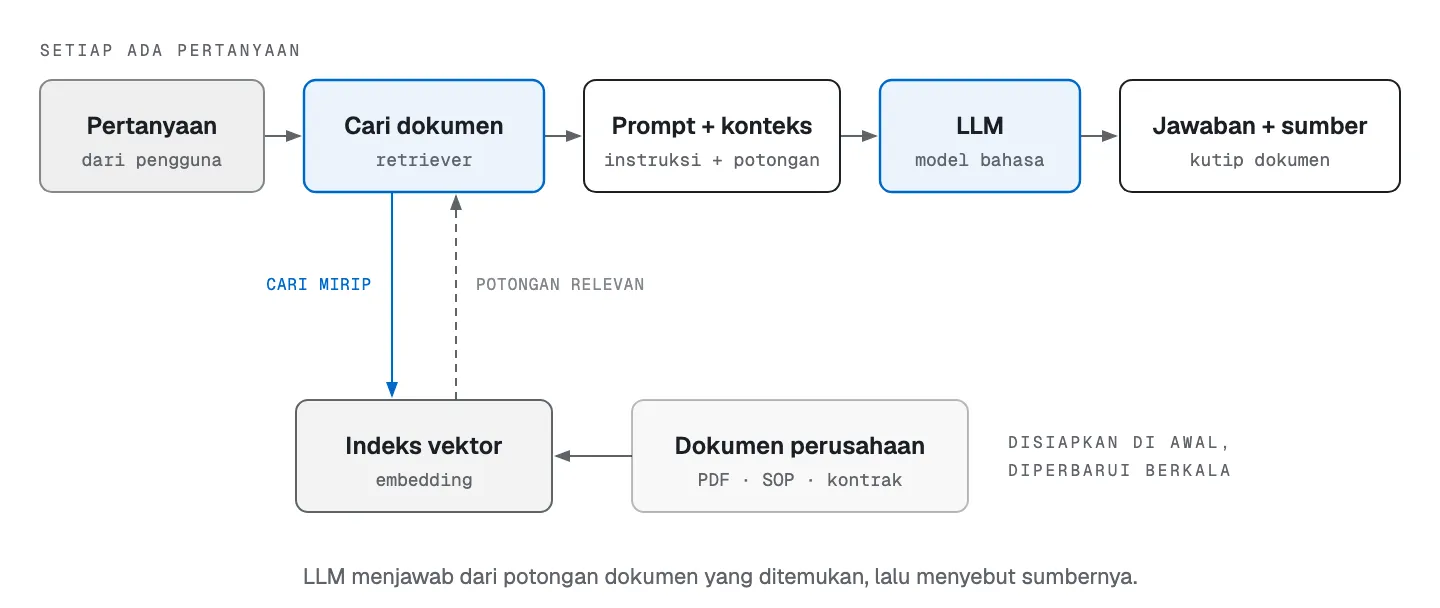
1. Kumpulan dokumen. Sumbernya bisa SOP dalam PDF, file di Google Drive, halaman wiki internal, katalog produk, atau riwayat tiket layanan pelanggan.
2. Pemotongan (chunking). Dokumen dipecah jadi potongan kecil, misalnya per paragraf atau per bagian. Tujuannya supaya yang diambil nanti hanya bagian yang relevan, bukan satu dokumen utuh.
3. Embedding dan indeks vektor. Setiap potongan diubah jadi deretan angka yang mewakili maknanya, disebut embedding. Angka-angka ini disimpan di database khusus yang disebut vector database. Dengan cara ini, sistem bisa mencari potongan yang maknanya mirip dengan pertanyaan, walau kata-katanya berbeda. Misalnya pertanyaan “uang makan saat dinas luar kota” tetap bisa menemukan paragraf berjudul “tunjangan perjalanan”.
4. Retriever. Saat ada pertanyaan, retriever mencari beberapa potongan yang paling relevan dari indeks.
5. Prompt + konteks. Potongan tadi digabung dengan pertanyaan dan instruksi, misalnya “jawab hanya berdasarkan dokumen berikut, dan sebutkan sumbernya”.
6. LLM. Model bahasa menyusun jawaban dari konteks yang diberikan, lalu menyertakan rujukan ke dokumen asalnya.
Contoh pemakaian RAG di bisnis
Beberapa contoh yang realistis:
- Tanya jawab SOP untuk karyawan. Misalnya sebuah distributor punya puluhan SOP gudang dan keuangan. Staf baru cukup bertanya, lalu mendapat jawaban beserta nama dokumen dan bagiannya.
- Asisten tim customer service. AI mencari jawaban dari basis pengetahuan produk dan riwayat tiket, lalu menyiapkan draf balasan. Agen tetap memeriksa sebelum mengirim.
- Pencarian klausul kontrak. Contoh di agensi: tim ingin tahu klien mana saja yang kontraknya punya klausul revisi tak terbatas. RAG membantu menemukan dan merangkum bagian yang relevan.
- Katalog produk untuk tim sales. Sales bisa bertanya spesifikasi teknis atau perbandingan produk tanpa membuka belasan brosur PDF.
- Aturan akademik di sekolah. Guru dan staf administrasi bisa mencari aturan penilaian atau prosedur perizinan dengan bahasa sehari-hari.
Perhatikan polanya: RAG paling berguna untuk pertanyaan yang jawabannya sudah ada di dokumen, tapi sulit dicari karena dokumennya banyak atau tersebar.
Kesalahan umum saat implementasi
RAG terlihat sederhana di demo, tapi banyak proyek gagal di tahap pemakaian nyata. Kesalahan yang sering terjadi:
- Dokumennya berantakan. Kalau ada tiga versi SOP yang saling bertentangan, AI juga akan bingung. Rapikan dan tandai versi yang berlaku sebelum dimasukkan.
- Dokumen hasil scan tidak bisa dibaca. PDF hasil scan harus diubah dulu jadi teks lewat OCR. Tanpa itu, isinya tidak ikut terindeks.
- Potongan terlalu besar atau terlalu kecil. Potongan terlalu besar membuat jawaban kabur. Terlalu kecil membuat konteksnya hilang, misalnya tabel yang terpotong di tengah.
- Tidak menyebut sumber. Tanpa rujukan, pengguna tidak bisa mengecek kebenaran jawaban dan kepercayaan cepat turun.
- Tidak ada aturan akses. Kalau dokumen gaji dan dokumen umum dicampur dalam satu indeks, staf biasa bisa mendapat jawaban yang seharusnya rahasia. Pisahkan indeks atau terapkan filter sesuai hak akses.
- Tidak ada pengujian. Siapkan 30 sampai 50 pertanyaan nyata beserta jawaban yang benar, lalu uji sistemnya sebelum dipakai tim. Ulangi setiap kali dokumen atau pengaturannya berubah.
- Indeks tidak diperbarui. SOP berubah, tapi indeksnya masih versi lama. Jadwalkan pembaruan otomatis setiap ada dokumen baru atau revisi.
Satu hal lagi: RAG mengurangi jawaban ngawur, tapi tidak menghilangkannya sepenuhnya. Untuk keputusan penting seperti persetujuan kontrak atau angka keuangan, tetap libatkan orang untuk memeriksa.
Kalau tim Anda sering menghabiskan waktu mencari jawaban di tumpukan dokumen, Aqilatic bisa membantu menilai apakah RAG cocok dan dokumen mana yang perlu dirapikan dulu. Mulai dengan audit proses gratis, atau lihat layanan AI dan data kami.
Pertanyaan yang sering muncul
Apa bedanya RAG dengan fine-tuning?
Fine-tuning melatih ulang model dengan data Anda supaya gaya atau kemampuannya berubah. RAG tidak mengubah model, hanya memberinya dokumen yang relevan saat menjawab. Untuk informasi yang sering berubah, RAG biasanya lebih praktis karena cukup memperbarui dokumennya.
Apakah data perusahaan aman kalau memakai RAG?
Tergantung arsitekturnya. Perhatikan di mana dokumen disimpan, penyedia LLM mana yang dipakai, dan kebijakan penyimpanan datanya. Untuk data sensitif, pilih layanan yang tidak memakai data Anda untuk melatih model, atau pertimbangkan model yang dijalankan sendiri.
Berapa banyak dokumen yang dibutuhkan untuk mulai?
Tidak perlu banyak. Mulai dari satu kumpulan dokumen yang paling sering dicari, misalnya SOP operasional atau FAQ produk. Setelah terbukti membantu, baru tambahkan sumber lain.