Data Pipeline Adalah: Komponen dan Contoh Arsitektur
Data pipeline adalah rangkaian proses otomatis yang mengambil data dari berbagai aplikasi, membersihkan dan mengolahnya, lalu menyimpannya di satu tempat yang siap dipakai untuk laporan atau dashboard. Anggap saja seperti jalur pipa: data masuk dari satu ujung, melewati beberapa tahap, dan keluar di ujung lain dalam bentuk yang rapi.
Kalau dashboard Anda sering telat, angkanya beda-beda tergantung siapa yang merekap, atau setiap Senin pagi ada orang yang sibuk download CSV dari tiga aplikasi, kemungkinan besar yang Anda butuhkan adalah data pipeline. Artikel ini menjelaskan komponennya, jenisnya, dan contoh arsitektur yang masuk akal untuk bisnis kecil dan menengah.
Pengertian data pipeline
Di banyak bisnis, data berpindah secara manual. Contohnya di sebuah toko dengan beberapa cabang: admin setiap pagi export penjualan dari aplikasi kasir, download data iklan dari dashboard marketing, lalu menggabungkannya di Excel. Setelah itu baru angkanya dimasukkan ke laporan. Kalau admin cuti, laporannya ikut libur.
Data pipeline mengganti pekerjaan itu dengan proses yang berjalan sendiri sesuai jadwal. Hasilnya:
- Data selalu terbaru tanpa menunggu orang merekap.
- Aturan hitungnya sama setiap hari, karena ditulis sekali di pipeline.
- Riwayat tersimpan, sehingga Anda bisa melihat tren beberapa bulan ke belakang.
- Kesalahan lebih mudah dilacak, karena setiap tahap tercatat.
Data pipeline biasanya jadi fondasi di balik dashboard yang benar-benar dipercaya tim.
Komponen data pipeline
Hampir semua data pipeline terdiri dari empat bagian, apa pun tool-nya.
1. Ekstraksi (extract)
Tahap mengambil data dari sumbernya. Sumbernya bisa aplikasi kasir, software akuntansi, CRM, marketplace, Google Sheets, atau database aplikasi Anda sendiri. Cara mengambilnya:
- lewat API, yaitu jalur resmi yang disediakan aplikasi untuk bertukar data,
- lewat koneksi langsung ke database,
- lewat file export (CSV atau Excel) yang ditaruh di folder tertentu, kalau aplikasinya tidak punya API.
2. Transformasi (transform)
Tahap mengolah data mentah menjadi data yang siap dipakai. Pekerjaannya antara lain:
- membersihkan format tanggal, nominal, dan nama yang tidak seragam,
- menghapus data duplikat,
- menggabungkan data dari beberapa sumber, misalnya penjualan dengan data produk,
- menghitung metrik bisnis, seperti margin per produk atau omzet per cabang.
Tahap ini paling penting, karena di sinilah definisi angka ditentukan. Kalau “penjualan bersih” didefinisikan di sini, semua laporan akan memakai angka yang sama.
3. Load (penyimpanan)
Tahap menyimpan hasil olahan ke tempat tujuan, biasanya data warehouse, yaitu database yang dirancang khusus untuk analisis. Contohnya BigQuery, PostgreSQL, atau Snowflake. Untuk skala sangat kecil, tujuannya bisa saja Google Sheets, walau cepat terasa batasnya saat data bertambah.
Kalau Anda ingin tahu lebih jauh tentang salah satu pilihan populer, baca BigQuery adalah.
4. Orkestrasi
Orkestrasi adalah “pengatur lalu lintas” pipeline: kapan setiap tahap jalan, urutannya, apa yang dilakukan saat ada tahap yang gagal, dan siapa yang diberi tahu. Tanpa orkestrasi, pipeline hanyalah kumpulan script yang harus dijalankan manual.
Untuk tim kecil, orkestrasi bisa sesederhana penjadwalan di tool otomatisasi seperti n8n. Contohnya ada di artikel Schedule Trigger n8n. Untuk pipeline yang lebih besar, ada tool khusus seperti Airflow atau Dagster.
Batch vs streaming
Ada dua cara utama data mengalir di pipeline.
| Batch | Streaming | |
|---|---|---|
| Cara kerja | Data diproses berkelompok sesuai jadwal | Data diproses segera setelah terjadi |
| Contoh jadwal | Tiap jam, tiap malam, tiap awal bulan | Hitungan detik |
| Kompleksitas | Lebih sederhana | Lebih rumit dan mahal dirawat |
| Cocok untuk | Laporan harian, dashboard manajemen, rekap keuangan | Deteksi fraud, stok real time di banyak kanal, pelacakan armada |
Untuk sebagian besar UKM, batch sudah cukup. Pertanyaan yang perlu diajukan: keputusan apa yang benar-benar butuh data per detik? Biasanya jawabannya sedikit. Laporan penjualan yang diperbarui tiap jam atau tiap malam sudah jauh lebih baik daripada rekap manual mingguan.
Contoh pipeline untuk UKM
Misalnya sebuah distributor dengan aplikasi kasir di beberapa gudang, CRM untuk tim sales, dan Google Sheets untuk target bulanan. Pemiliknya ingin dashboard penjualan yang sudah siap setiap pagi.
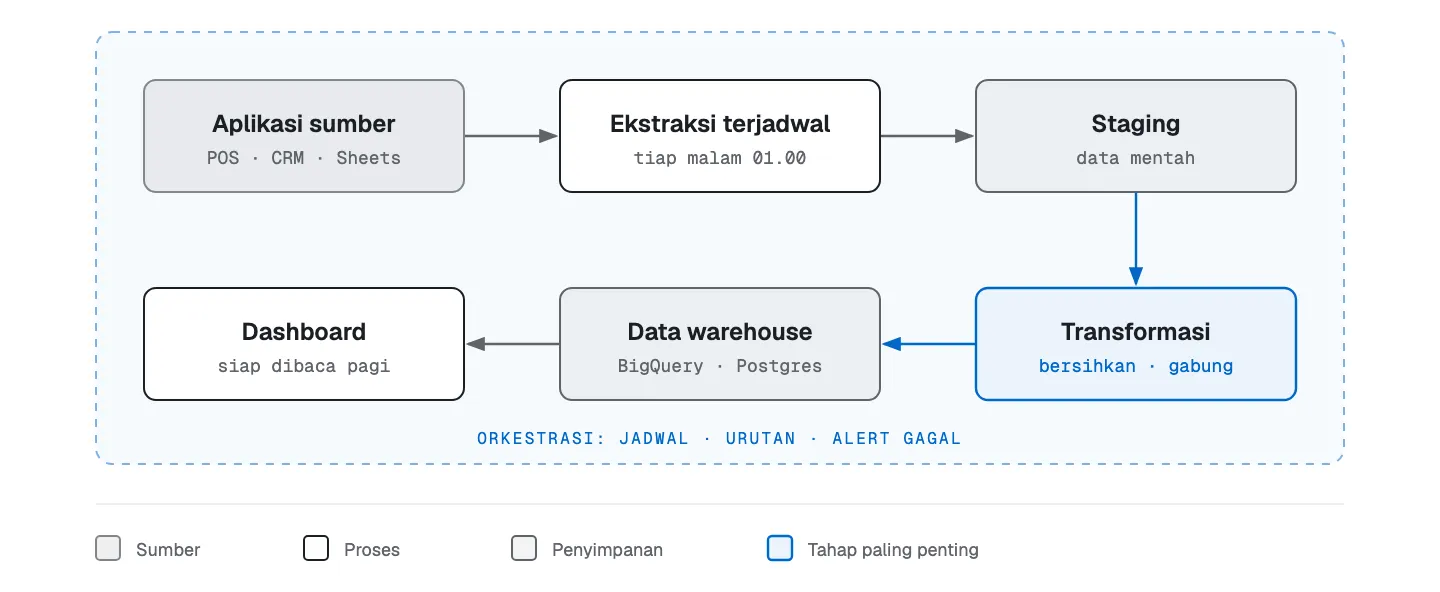
Alurnya:
- Ekstraksi terjadwal. Setiap malam jam 01.00, pipeline menarik transaksi kemarin dari aplikasi kasir dan CRM lewat API, serta membaca target dari Google Sheets.
- Staging. Data mentah disimpan apa adanya di area staging. Tujuannya supaya kalau ada masalah di tahap berikutnya, data asli masih ada dan tidak perlu ditarik ulang.
- Transformasi. Data dibersihkan, kode produk disamakan antar sistem, lalu dihitung omzet, margin, dan pencapaian target per sales.
- Data warehouse. Hasilnya disimpan dalam tabel yang rapi, lengkap dengan riwayat harian.
- Dashboard. Tool seperti Looker Studio (sejak April 2026 berganti nama menjadi Data Studio) atau Power BI membaca tabel itu. Jam 07.00, dashboard sudah berisi data kemarin.
- Orkestrasi. Mengatur urutan semua tahap di atas, dan mengirim alert ke tim kalau ada yang gagal.
Pipeline seperti ini tidak harus besar atau mahal. Banyak UKM bisa memulainya dengan satu sumber data dan satu dashboard, lalu menambah sumber lain bertahap. Contoh penerapan data lain bisa Anda lihat di bagian contoh penerapan.
Memantau pipeline
Pipeline yang tidak dipantau bisa gagal diam-diam. Dashboard tetap tampil, tapi angkanya berhenti di tiga hari lalu, dan tidak ada yang sadar. Ini lebih berbahaya daripada tidak punya dashboard sama sekali.
Hal minimal yang perlu dipantau:
- Status setiap eksekusi. Berhasil atau gagal, dan kalau gagal, di tahap mana.
- Kesegaran data (freshness). Kapan data terakhir masuk. Tampilkan tanggal “data per” di dashboard supaya pembaca tahu.
- Jumlah baris. Kalau biasanya ada 2.000 transaksi per hari lalu tiba-tiba 0 atau 20.000, ada yang tidak beres.
- Pengecekan angka kunci. Misalnya total penjualan di warehouse dibandingkan dengan total di aplikasi kasir.
Kirim alert ke email atau chat tim saat salah satu pengecekan gagal. Dengan begitu, masalah sudah ketahuan sebelum rapat dimulai.
Kalau dashboard Anda masih bergantung pada rekap manual, Aqilatic bisa membantu memetakan sumber data dan merancang pipeline yang sesuai skala bisnis Anda lewat audit proses gratis.
Pertanyaan yang sering muncul
Apa bedanya data pipeline dengan ETL?
ETL (extract, transform, load) adalah salah satu pola data pipeline, dengan urutan ambil, olah, lalu simpan. Data pipeline adalah istilah yang lebih luas, mencakup pola lain seperti ELT (data disimpan dulu, baru diolah di warehouse) dan streaming.
Apakah bisnis kecil perlu data pipeline?
Kalau Anda punya lebih dari satu sumber data dan ada orang yang rutin merekap manual untuk laporan, jawabannya sering ya. Pipeline sederhana dengan satu jadwal harian sudah bisa menghemat banyak jam per bulan.
Tool apa yang dipakai untuk membangun data pipeline?
Tergantung skala. Untuk awal, tool otomatisasi seperti n8n atau script terjadwal sudah cukup. Untuk volume dan kompleksitas lebih besar, tim biasanya memakai kombinasi tool ekstraksi, data warehouse seperti BigQuery, dan tool transformasi seperti dbt.