Memilih Model LLM untuk Bisnis: Biaya, Kecepatan, Akurasi
Model LLM terbaik untuk bisnis Anda jarang yang paling pintar di papan peringkat. Model yang tepat adalah yang cukup akurat untuk tugasnya, cukup cepat untuk alurnya, dan biayanya masuk akal di volume Anda. Cara paling andal untuk memilih LLM adalah menguji beberapa kandidat dengan data Anda sendiri, lalu memilih model termurah yang lolos standar kualitas.
Artikel ini untuk tim teknis yang sedang membangun otomatisasi, misalnya ekstraksi data faktur, klasifikasi email, atau ringkasan laporan, dan harus memutuskan model mana yang dipakai. Kalau istilah LLM masih baru untuk Anda, baca dulu penjelasan LLM untuk bisnis.
Faktor pemilihan model
Ada lima faktor yang biasanya menentukan. Urutan pentingnya berbeda untuk tiap kasus.
- Akurasi untuk tugas Anda. Skor benchmark umum hanya gambaran kasar. Model yang jago menulis puisi belum tentu jago membaca faktur pajak berbahasa Indonesia.
- Biaya per task. Penyedia API umumnya menagih per token (potongan kata), dan harga token output biasanya lebih mahal dari input. Yang penting dihitung adalah biaya satu tugas utuh, misalnya satu dokumen, dikali volume per bulan.
- Kecepatan (latency). Untuk proses di belakang layar seperti rekap malam hari, lambat beberapa detik tidak masalah. Untuk sesuatu yang ditunggu pengguna, kecepatan jadi syarat utama.
- Keamanan dan lokasi data. Data apa yang dikirim ke penyedia model, disimpan berapa lama, dan apakah dipakai untuk pelatihan. Cek syarat layanan versi bisnis atau API, jangan hanya versi aplikasi chat.
- Fitur pendukung. Misalnya dukungan structured output (jawaban dalam format JSON yang pasti), panjang konteks, kemampuan membaca gambar atau PDF, dan tool calling.
Model besar vs kecil
Hampir semua penyedia punya beberapa kelas model: besar, menengah, dan kecil. Model besar lebih kuat untuk penalaran rumit, tapi lebih mahal dan lebih lambat. Model kecil jauh lebih murah dan cepat, dan sering sudah cukup untuk tugas yang sempit dan jelas.
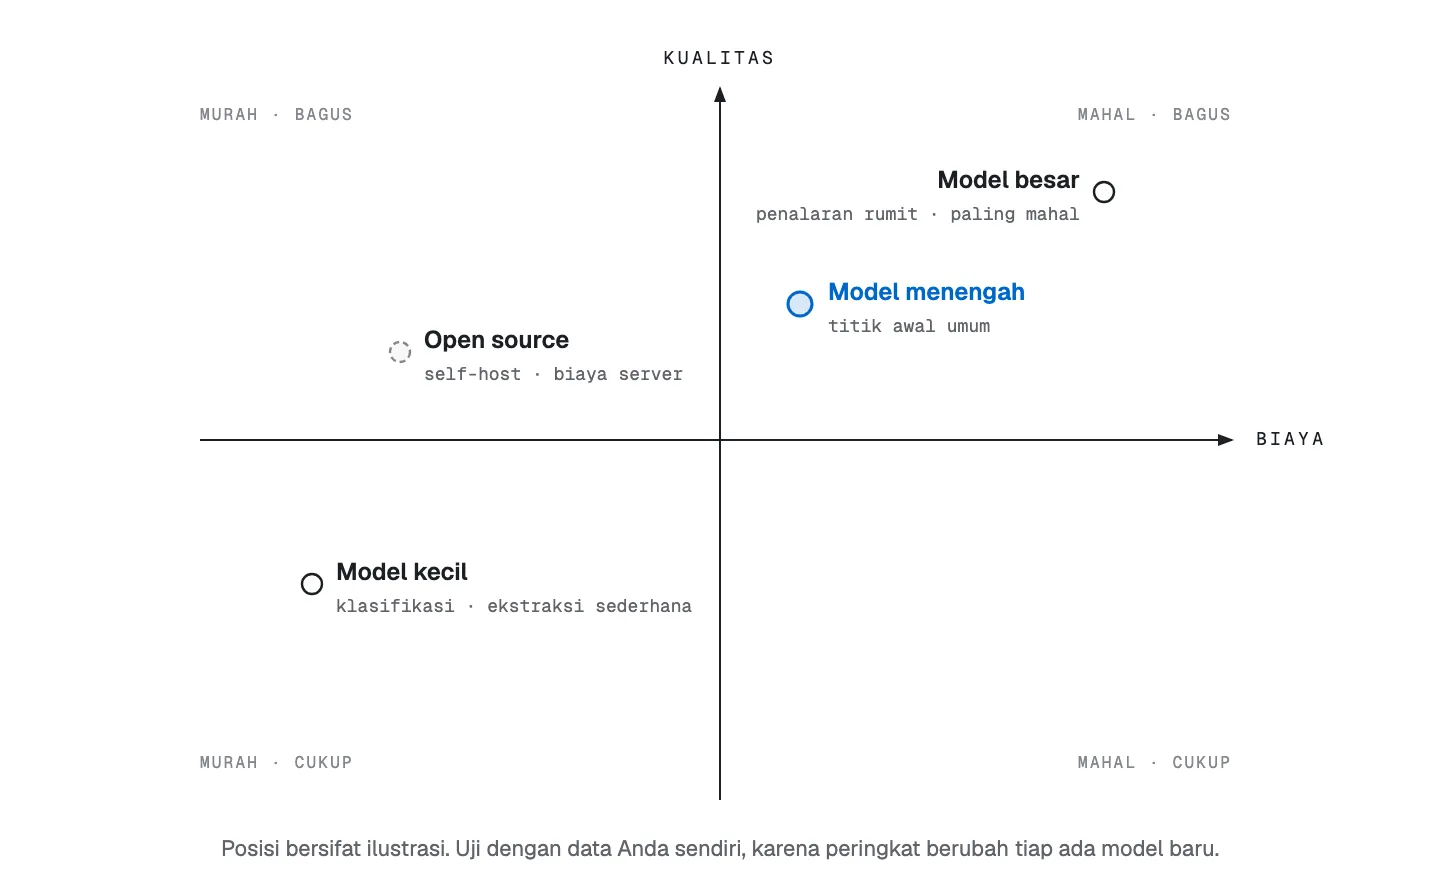
Contoh pembagian tugas yang sering masuk akal:
| Jenis tugas | Kelas model yang biasanya cukup |
|---|---|
| Klasifikasi email ke 5 kategori | Kecil |
| Ekstraksi field dari faktur dengan format standar | Kecil atau menengah |
| Ringkasan notulen rapat | Menengah |
| Menjawab pertanyaan dari dokumen internal (RAG) | Menengah |
| Analisis kontrak atau penalaran multi-langkah | Besar |
Anggap tabel ini titik awal. Satu-satunya cara tahu adalah menguji.
Kesalahan yang sering terjadi: tim langsung memakai model terbesar untuk semua hal karena “biar aman”. Untuk volume kecil tidak terasa. Tapi saat workflow memproses ribuan dokumen per bulan, selisih biayanya bisa berlipat-lipat tanpa peningkatan akurasi yang berarti.
Model tertutup vs terbuka
Model tertutup diakses lewat API penyedia, misalnya model dari OpenAI, Anthropic, atau Google. Anda tidak mengurus server. Kualitas model teratasnya umumnya masih memimpin, dan pembaruannya cepat.
Model terbuka (open weight) bobot modelnya bisa diunduh dan dijalankan sendiri, misalnya keluarga Llama, Qwen, Mistral, atau Gemma. Istilah yang lebih tepat sebenarnya “open weight”, karena lisensinya berbeda-beda. Sebagian punya syarat pemakaian tertentu, jadi baca lisensinya sebelum dipakai komersial.
Pertimbangan praktisnya:
- Pilih model terbuka kalau data benar-benar tidak boleh keluar dari server Anda, volume sangat tinggi dan stabil, atau Anda butuh kontrol penuh atas versi model.
- Pilih model tertutup kalau tim kecil dan tidak punya orang untuk mengurus GPU, volume masih naik turun, atau butuh kualitas tertinggi.
Satu hal yang sering dilupakan: model terbuka tidak berarti gratis. Menjalankannya butuh server GPU, orang yang merawat, dan pemantauan. Untuk volume kecil sampai menengah, API sering justru lebih murah. Soal data apa yang aman dikirim ke model, kami bahas di artikel keamanan data saat memakai AI.
Menguji dengan data sendiri
Ini langkah paling penting dan paling sering dilewati. Caranya tidak harus rumit:
- Kumpulkan 50 sampai 100 contoh nyata. Misalnya 80 faktur dari berbagai vendor, termasuk yang buram dan formatnya aneh.
- Siapkan jawaban yang benar. Isi manual oleh orang yang paham. Ini jadi kunci jawaban.
- Jalankan prompt yang sama ke 3 atau 4 model. Pakai format output yang sama, idealnya JSON dengan field yang sudah ditentukan.
- Bandingkan hasilnya per field. Hitung berapa persen yang benar, catat jenis kesalahannya, ukur waktu dan biaya per dokumen.
- Tentukan ambang minimal. Misalnya “nomor faktur dan nominal harus 99% benar, nama vendor boleh 95%”.
- Pilih model termurah yang lolos ambang. Simpan set pengujian ini untuk dipakai lagi saat ada model baru.
Jenis kesalahan sama pentingnya dengan persentase. Model yang salah menulis nama vendor masih bisa ditoleransi. Model yang sesekali mengarang nominal jauh lebih berbahaya. Cara menekan jawaban ngawur seperti ini kami bahas di artikel halusinasi AI.
Strategi campuran
Dalam praktik, sistem yang hemat jarang memakai satu model saja. Beberapa pola yang umum:
- Routing berdasarkan tingkat kesulitan. Model kecil menangani semua dokumen dulu. Kalau skor keyakinannya rendah atau validasi gagal, dokumen dikirim ulang ke model yang lebih besar.
- Model berbeda per langkah. Misalnya model kecil untuk klasifikasi jenis dokumen, model menengah untuk ekstraksi, dan manusia untuk review kasus aneh.
- Validasi tanpa AI. Cek hasil dengan aturan biasa: total harus sama dengan jumlah item, format NPWP harus sesuai panjang digit, tanggal tidak boleh di masa depan. Aturan sederhana ini murah dan menangkap banyak kesalahan.
- Siapkan cadangan penyedia. Buat alur otomatisasi Anda tidak terkunci ke satu penyedia. Kalau satu API sedang gangguan atau harga berubah, Anda bisa pindah dengan mengganti konfigurasi.
Tool seperti n8n memudahkan pola ini karena node AI bisa diganti modelnya tanpa membangun ulang seluruh workflow. Contoh penerapan AI di proses bisnis bisa Anda lihat di bagian layanan kami.
Harga dan jajaran model berubah cepat. Per November 2026, penyedia besar masih rutin merilis model baru, jadi jadwalkan pengujian ulang setiap beberapa bulan dengan set data yang sama.
Kalau tim Anda sedang menimbang model untuk sebuah otomatisasi dan ingin pendapat kedua, Aqilatic bisa membantu menyusun pengujiannya lewat audit proses gratis.
Pertanyaan yang sering muncul
Apakah model paling mahal selalu paling akurat?
Untuk tugas rumit, biasanya lebih baik. Untuk tugas sempit seperti klasifikasi atau ekstraksi format standar, selisihnya sering kecil. Karena itu pengujian dengan data sendiri lebih bisa dipegang daripada harga.
Berapa banyak data yang dibutuhkan untuk menguji model?
Untuk keputusan awal, 50 sampai 100 contoh yang mewakili variasi nyata sudah cukup. Pastikan contoh sulit ikut masuk, jangan hanya dokumen yang rapi.
Apakah perlu fine-tuning?
Untuk kebanyakan otomatisasi bisnis, tidak. Prompt yang jelas, contoh di dalam prompt, structured output, dan validasi biasanya sudah cukup. Fine-tuning baru dipertimbangkan kalau cara-cara itu sudah dicoba dan akurasinya tetap kurang.