RAG di n8n: Tanya Jawab Dokumen Internal Perusahaan
RAG di n8n adalah workflow yang membuat karyawan bisa bertanya ke dokumen internal perusahaan, misalnya SOP, kebijakan cuti, atau panduan produk, lalu mendapat jawaban yang diambil dari dokumen itu sendiri. n8n menyiapkan dokumennya, mencari bagian yang relevan saat ada pertanyaan, lalu meminta LLM menyusun jawaban lengkap dengan sumbernya.
Kalau tim HR atau operasional Anda menjawab pertanyaan yang sama berkali-kali (“cuti melahirkan berapa hari?”, “cara klaim biaya perjalanan gimana?”), padahal jawabannya sudah ada di dokumen, RAG bisa mengurangi beban itu.
Istilah RAG (Retrieval-Augmented Generation) sendiri sudah kami jelaskan di artikel RAG adalah. Artikel ini fokus ke cara membangunnya di n8n.
Arsitektur RAG di n8n
Workflow RAG di n8n terdiri dari dua bagian yang berjalan terpisah.
Bagian pertama: menyiapkan dokumen. Dokumen diambil dari sumbernya, dipotong jadi bagian-bagian kecil (chunk), diubah jadi embedding, lalu disimpan di vector store. Embedding adalah representasi angka dari makna sebuah teks, sehingga sistem bisa mencari teks yang maknanya mirip, tidak hanya kata yang persis sama. Vector store adalah database yang menyimpan embedding itu.
Bagian kedua: menjawab pertanyaan. Saat karyawan bertanya, pertanyaannya juga diubah jadi embedding, lalu dicari potongan dokumen yang paling mirip. Potongan itu diberikan ke LLM sebagai bahan jawaban.
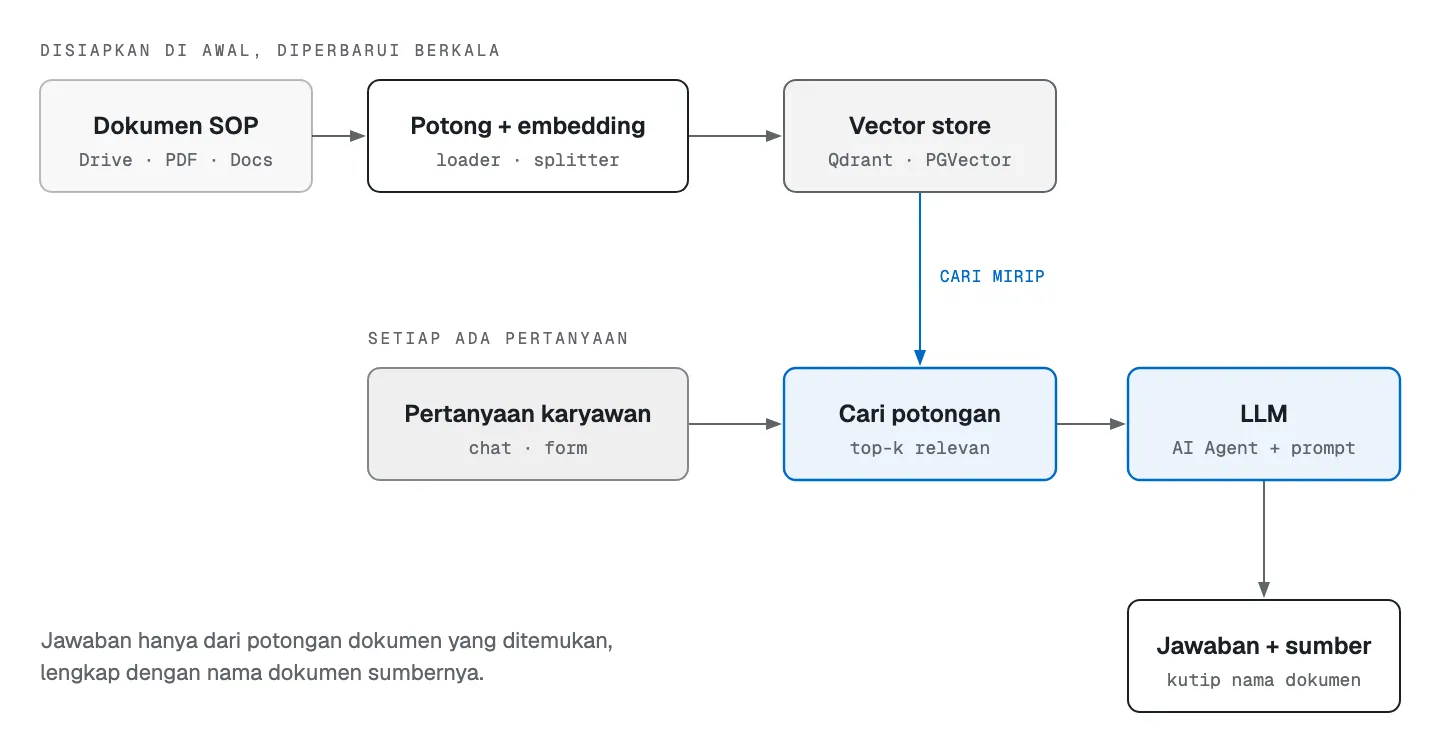
Bagian pertama cukup dijalankan saat dokumen berubah. Bagian kedua jalan setiap ada pertanyaan.
Memasukkan dokumen ke vector store
Workflow penyiapan dokumen biasanya berisi node berikut:
- Trigger. Bisa manual untuk pertama kali, lalu Schedule Trigger atau trigger Google Drive untuk pembaruan.
- Ambil dokumen. Misalnya node Google Drive untuk mengunduh file dari folder “SOP Resmi”.
- Vector store dengan operasi Insert Documents. Node ini menerima dokumen dan menyimpannya.
- Default Data Loader. Sub-node yang membaca isi file dan memotongnya jadi chunk.
- Text splitter. Menentukan cara memotong. n8n menyediakan Character, Recursive Character, dan Token Text Splitter. Recursive Character Text Splitter direkomendasikan untuk kebanyakan kasus.
- Embeddings. Sub-node model embedding, misalnya dari OpenAI atau penyedia lain yang didukung.
Untuk vector store, n8n punya beberapa pilihan, antara lain Simple Vector Store, Qdrant, Pinecone, Supabase, dan PGVector (PostgreSQL). Satu catatan penting: Simple Vector Store menyimpan data di memori. Datanya hilang saat n8n restart, dan n8n sendiri menyarankan node ini hanya untuk pengembangan. Untuk pemakaian sungguhan, pilih vector store yang menyimpan data secara permanen. Kalau Anda sudah memakai PostgreSQL, PGVector sering jadi pilihan paling praktis.
Beberapa tips saat menyiapkan dokumen:
- Pakai dokumen resmi saja. Jangan campur draf lama dengan versi final. RAG akan mengutip apa pun yang ada di vector store.
- Tambahkan metadata. Simpan nama file, tanggal berlaku, dan departemen di setiap chunk. Metadata ini nanti dipakai untuk menampilkan sumber.
- Coba ukuran chunk. Chunk terlalu kecil membuat konteks terpotong. Terlalu besar membuat pencarian kurang tajam. Mulai dari pengaturan bawaan, lalu uji dengan pertanyaan nyata.
- Pakai model embedding yang sama. Model embedding saat memasukkan dokumen harus sama dengan saat mencari. Kalau diganti, semua dokumen perlu dimasukkan ulang.
Retrieval dan prompt jawaban
Untuk bagian tanya jawab, ada dua cara umum di n8n.
Cara pertama: AI Agent dengan vector store sebagai tool. Pertanyaan masuk lewat Chat Trigger atau form, lalu diteruskan ke node AI Agent. Vector store dipasang sebagai tool, sehingga agen bisa mencari ke dokumen saat dibutuhkan. Cara ini fleksibel kalau agen juga punya tool lain.
Cara kedua: rantai tanya jawab. Pakai node Question and Answer Chain dengan Vector Store Retriever. Alurnya lebih lurus: selalu cari dokumen dulu, baru jawab. Untuk kasus “tanya ke SOP”, cara ini sering lebih mudah diprediksi.
Apa pun caranya, prompt sistem sangat menentukan kualitas jawaban. Contoh instruksi yang bisa Anda pakai sebagai titik awal:
- Jawab hanya berdasarkan potongan dokumen yang diberikan.
- Kalau jawabannya tidak ada di dokumen, katakan tidak tahu dan sarankan menghubungi HR.
- Sebutkan nama dokumen dan bagian yang menjadi sumber jawaban.
- Jawab singkat dalam bahasa Indonesia yang mudah dipahami.
Kalau tim Anda baru mengenal LLM, baca dulu LLM adalah supaya paham kenapa instruksi seperti ini perlu ditulis eksplisit.
Menjaga jawaban tetap bersumber
Masalah terbesar RAG bukan teknis, melainkan kepercayaan. Kalau sekali saja karyawan mendapat jawaban yang salah soal aturan cuti, mereka akan kembali bertanya ke HR.
Beberapa cara menjaga jawaban tetap bisa dipertanggungjawabkan:
- Selalu tampilkan sumber. Setiap jawaban menyertakan nama dokumen dan, kalau bisa, tautannya. Karyawan bisa mengecek sendiri.
- Batasi jumlah potongan. Ambil beberapa potongan paling relevan saja. Terlalu banyak konteks justru membuat jawaban melebar.
- Siapkan jawaban “tidak tahu”. Lebih baik sistem bilang “tidak ditemukan di dokumen” daripada mengarang.
- Uji dengan daftar pertanyaan. Kumpulkan 20 sampai 30 pertanyaan nyata dari HR atau operasional, lengkap dengan jawaban yang benar. Jalankan setiap kali Anda mengubah prompt atau ukuran chunk.
- Catat pertanyaan dan jawaban. Simpan log ke spreadsheet atau database. Dari sini Anda tahu pertanyaan apa yang sering gagal dijawab, dan dokumen mana yang perlu diperjelas.
Satu hal lagi soal akses: kalau dokumen berisi informasi sensitif seperti gaji atau data karyawan, jangan masukkan ke vector store yang bisa ditanya semua orang. Pisahkan koleksi dokumen berdasarkan siapa yang boleh membacanya.
Update dokumen secara berkala
SOP berubah. Kebijakan diperbarui. Kalau vector store tidak ikut diperbarui, RAG akan menjawab dengan aturan lama, dan itu lebih berbahaya daripada tidak ada jawaban sama sekali.
Pola update yang umum:
- Jadwalkan pengecekan. Misalnya setiap malam, workflow mengecek folder SOP di Google Drive untuk file yang diubah sejak pengecekan terakhir. Cara membuat jadwal ada di artikel Schedule Trigger n8n.
- Hapus versi lama. Sebelum memasukkan dokumen yang diperbarui, hapus chunk lama berdasarkan metadata nama file atau ID dokumen. Cara menghapusnya tergantung vector store yang dipakai.
- Masukkan versi baru. Jalankan ulang alur Insert Documents untuk file tersebut saja.
- Kirim ringkasan. Beri tahu admin dokumen apa saja yang diperbarui malam itu.
Dengan pola ini, tim HR cukup memperbarui file di folder yang sama seperti biasa. Sistem yang mengurus sisanya.
Ingin workflow seperti ini dibangun dan dirawat oleh tim yang terbiasa dengan n8n? Lihat layanan kami. Kalau Anda belum yakin dokumen mana yang layak dijadikan sumber tanya jawab, Aqilatic bisa membantu memetakannya lewat audit proses gratis.
Pertanyaan yang sering muncul
Apakah RAG di n8n bisa dijalankan di n8n self-hosted?
Bisa. Node AI dan vector store tersedia di versi self-hosted maupun cloud. Anda tetap perlu akses ke model embedding dan LLM, baik lewat API penyedia maupun model yang dijalankan sendiri.
Format dokumen apa yang bisa dipakai?
Default Data Loader bisa membaca file teks maupun file biner seperti PDF, dengan mendeteksi jenis file dari MIME type-nya. Google Docs biasanya diekspor dulu ke teks atau PDF saat diunduh. PDF hasil scan perlu diproses OCR dulu supaya teksnya bisa dibaca.
Apakah jawaban RAG pasti benar?
Tidak pasti. RAG mengurangi jawaban ngawur karena LLM diberi bahan dari dokumen, tapi tetap perlu uji rutin, tampilan sumber, dan jalur ke manusia untuk pertanyaan penting.